Eine API für jedes Modell
Chat Completions, die Anthropic Messages API und die Responses API, dazu Embeddings und Transkription, alles mit demselben Key.
03 Serve $ hyai models
Gemeinsam genutzt pro Token oder nur für Sie, aus europäischen Rechenzentren.
 GLM
 DeepSeek
 Qwen
 Kimi
 Mistral
 Llama
 gpt-oss
 Gemma
 Loes
 Nemotron
 Claude Code
 Codex
 OpenCode
 Cursor
 Cline
Loes
OpenAI SDK
 Anthropic SDK
Was es leistet
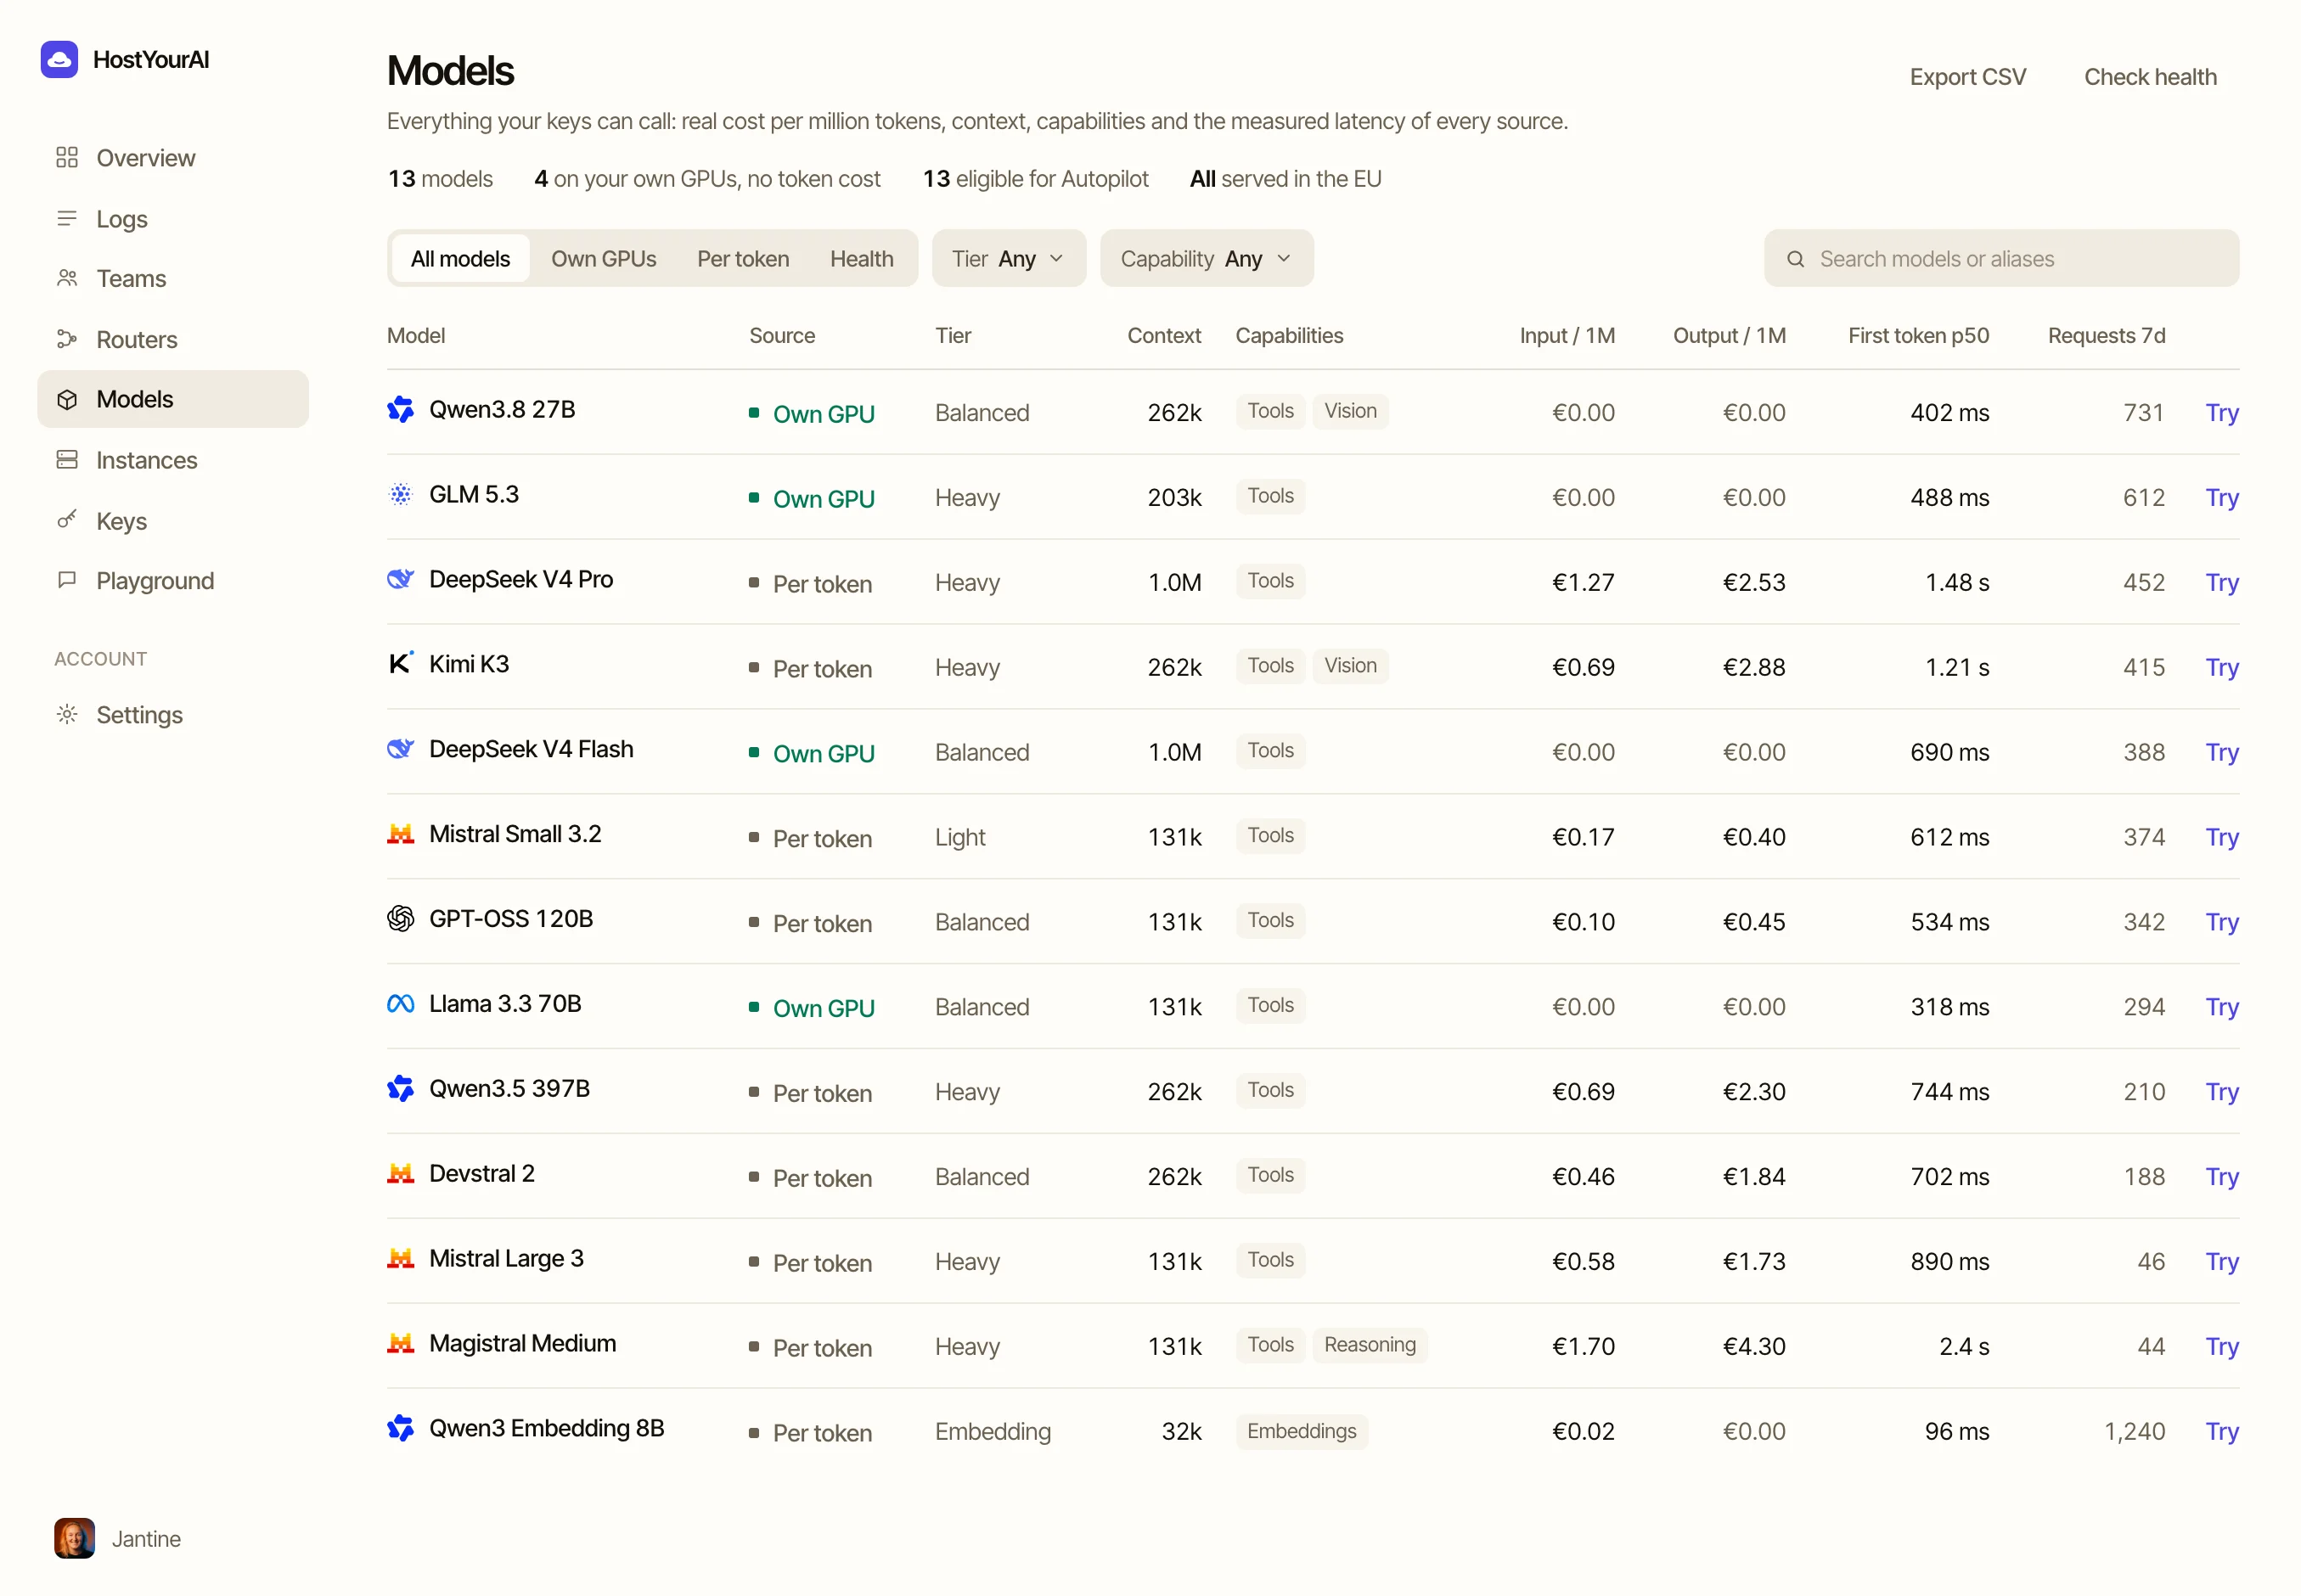
Der Model Garden listet die offenen Modelle, die Sie jetzt aufrufen können. Geteilte Modelle laufen pro Token auf GPUs in Europa: Sie zahlen, was Sie nutzen, und müssen keine Maschine verwalten. Jedes Modell hat eine eigene Seite mit Kontextlänge, Preis pro Million Tokens und Qualitätswert.
Wenn ein Modell nur für Sie arbeiten soll, betreiben Sie es auf einer dedizierten GPU. Sie erstellen und löschen sie selbst, im Dashboard oder über die API, und zahlen pro GPU-Minute, solange sie läuft. Mit einer privaten Verbindung bleibt ihr Port für das öffentliche Internet geschlossen.
Hinter einem Modellnamen können mehrere Quellen stehen. Der Router schickt jede Anfrage an eine Quelle, die gesund und schnell ist, hält eine Unterhaltung auf der Maschine mit ihrem Cache und wechselt, wenn eine Maschine langsamer wird.
Weiterlesen
DeepSeek V4.1 Flash
DeepSeek V4 Flash
GLM 5.3 Flash
Qwen3.8 27B
Kein Modell gefunden. Alle Modelle ansehen
Chat Completions, die Anthropic Messages API und die Responses API, dazu Embeddings und Transkription, alles mit demselben Key.
Wiederholte Prompt-Präfixe werden automatisch zu einem niedrigeren Satz abgerechnet. Sie müssen nichts zusätzlich senden.
Jedes Modell trägt einen Bench-Wert aus öffentlichen Benchmarks, gekennzeichnet als gemessen oder geschätzt, und die Rankings zeigen die gemessene Geschwindigkeit pro Modell.
Betreiben Sie ein Modell von Hugging Face oder Ihr eigenes Finetune auf einer dedizierten GPU, gestartet mit dem offiziellen vLLM-Rezept für dieses Modell.
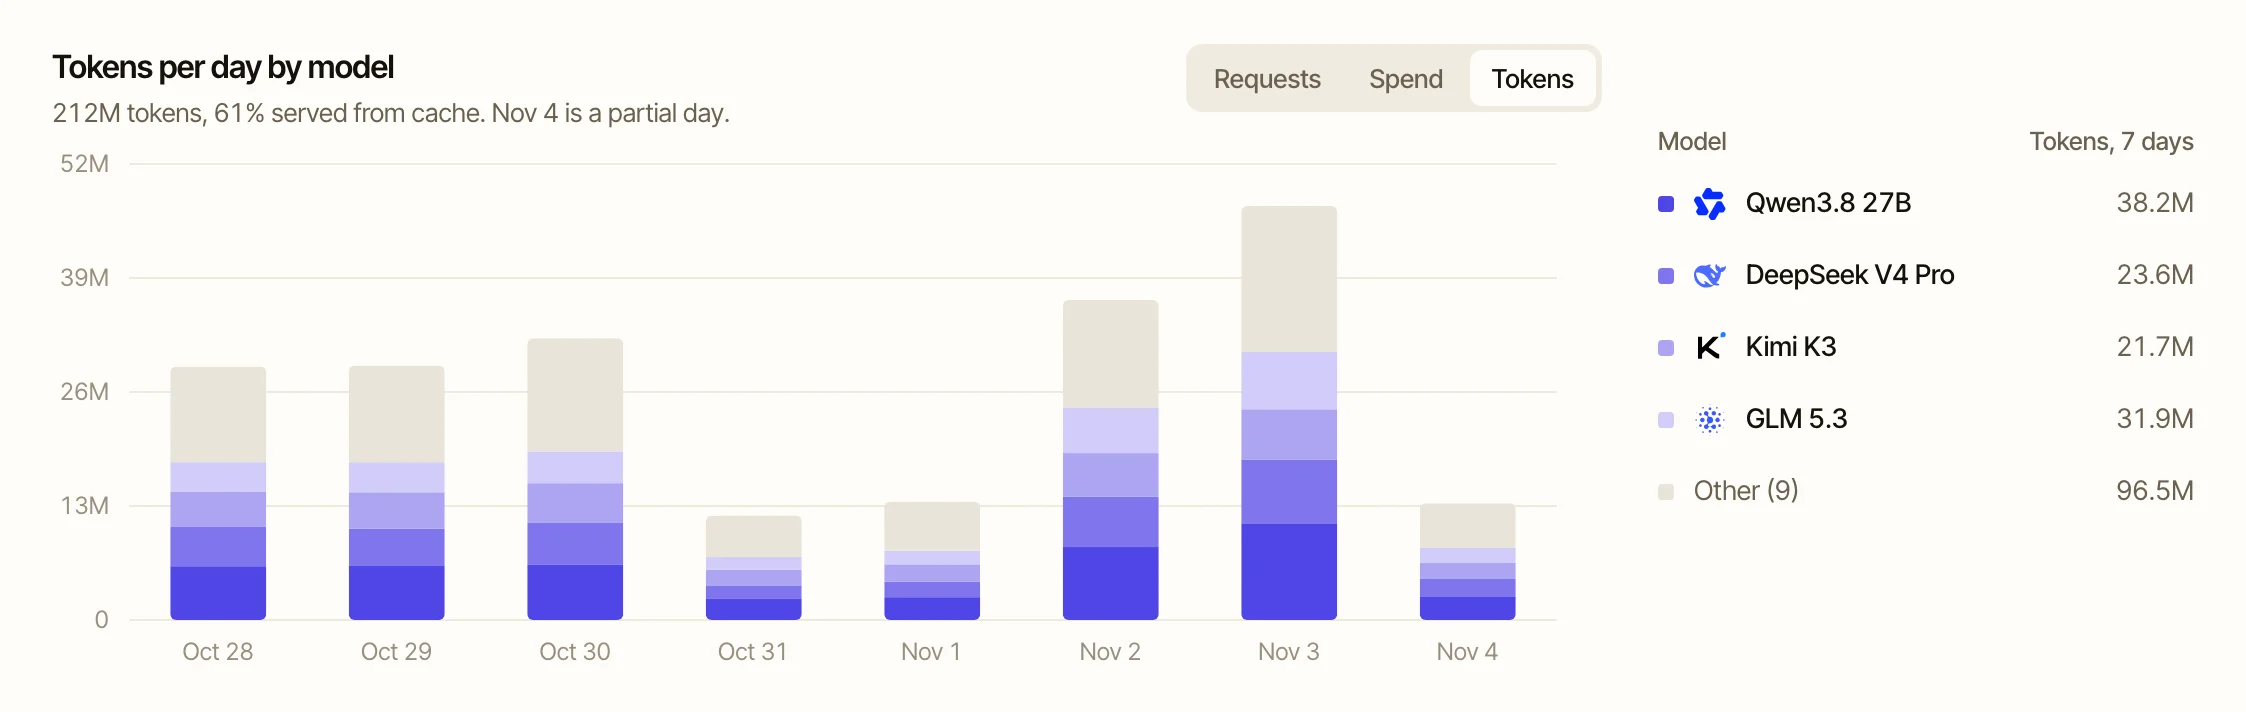
Jedes Modell im Model Garden, das als verfügbar angezeigt wird. Neue offene Modelle nehmen wir auf, nachdem wir sie getestet haben.
Wenn die Arbeit ein Modell braucht, das sonst niemand betreibt, eine garantierte Geschwindigkeit oder vollständige Isolation. Für die meisten Teams bleibt geteilt pro Token günstiger, bis das Volumen sehr groß wird.
Ja. Setzen Sie die Base-URL auf https://hostyourai.com/api/v1 und verwenden Sie Ihren HostYourAI-Key. Das Anthropic SDK funktioniert genauso.
Starten Sie mit einer Ebene und ergänzen Sie die anderen, wenn die Arbeit es verlangt. Alle teilen sich einen Key, ein Guthaben und eine Activity-Ansicht.
Ein Key gibt Ihnen jedes Modell im Garden. Laden Sie Guthaben auf und zahlen Sie pro Token, ohne Abonnement.