Une API pour tous les modèles
Chat Completions, l'API Anthropic Messages et l'API Responses, plus les embeddings et la transcription, le tout avec la même clé.
03 Serve $ hyai models
Partagés au token, ou rien que pour vous, depuis des centres de données européens.
 GLM
 DeepSeek
 Qwen
 Kimi
 Mistral
 Llama
 gpt-oss
 Gemma
 Loes
 Nemotron
 Claude Code
 Codex
 OpenCode
 Cursor
 Cline
Loes
OpenAI SDK
 Anthropic SDK
Ce que cela fait
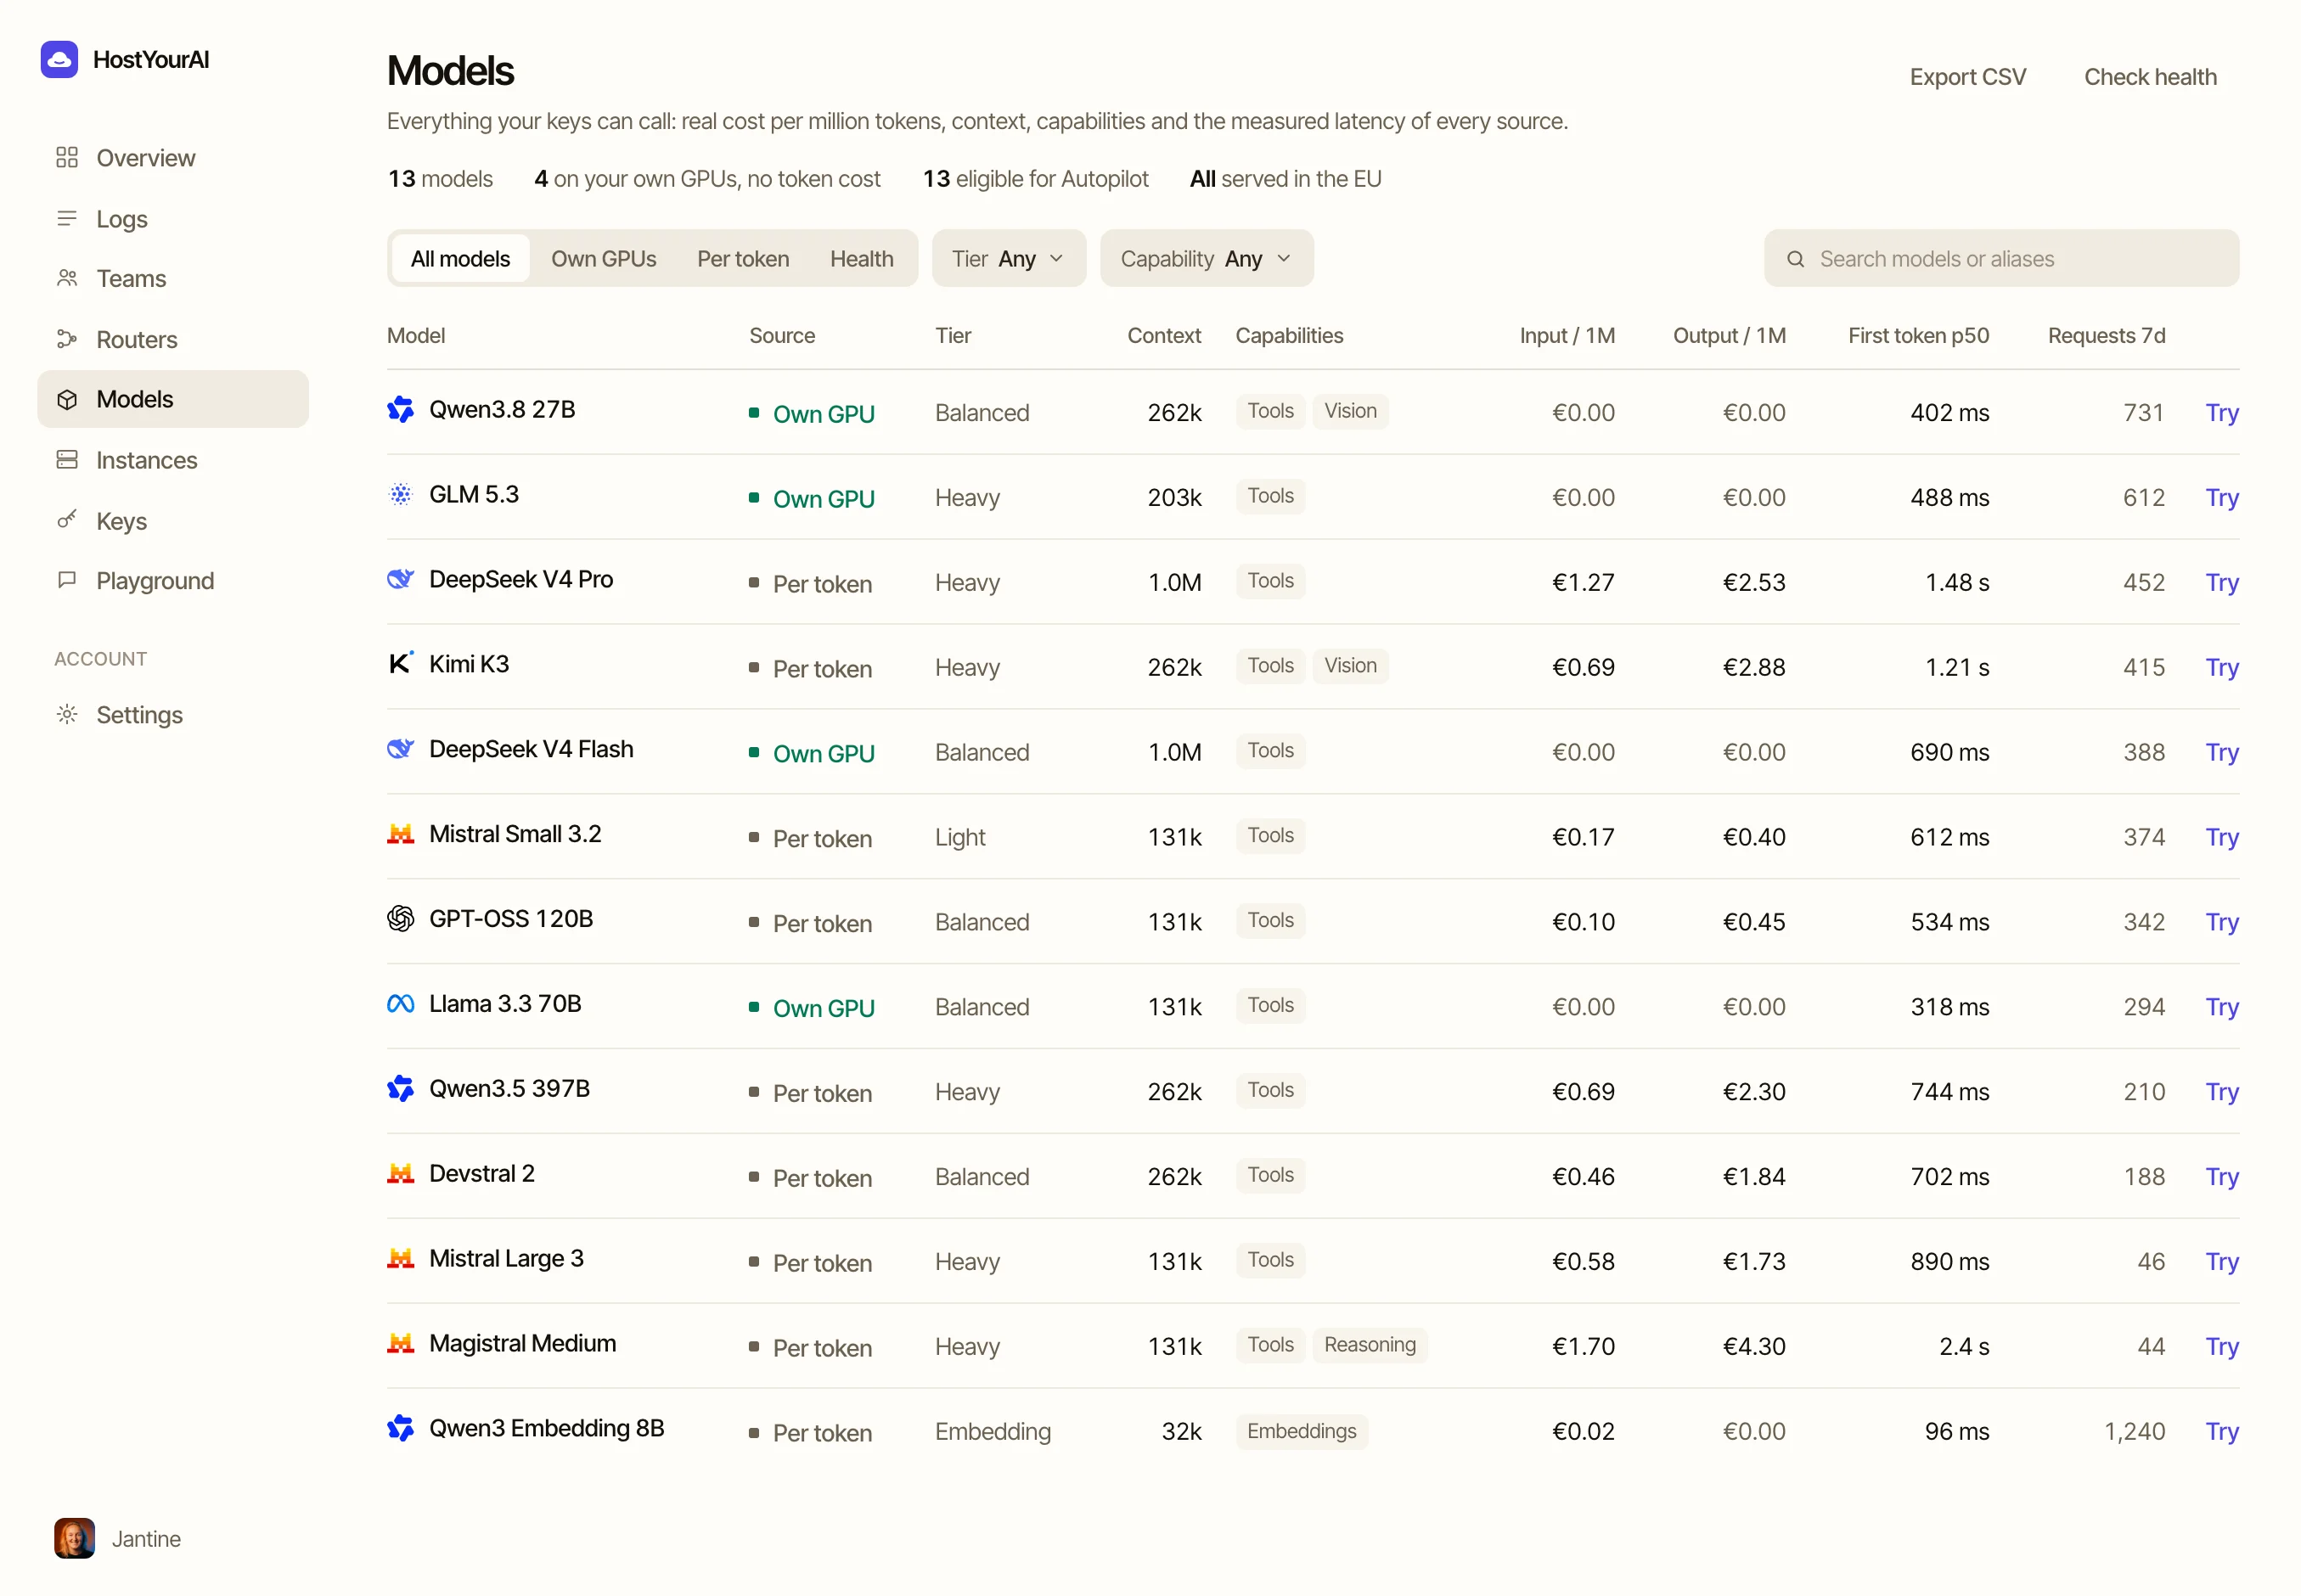
Le model garden liste les modèles ouverts que vous pouvez appeler dès maintenant. Les modèles partagés tournent au token sur des GPU en Europe : vous payez ce que vous utilisez et il n'y a aucune machine à gérer. Chaque modèle a sa propre page avec sa longueur de contexte, son prix par million de tokens et un score de qualité.
Quand un modèle doit travailler uniquement pour vous, faites-le tourner sur un GPU dédié. Vous le créez et le supprimez vous-même, dans le tableau de bord ou via l'API, et vous payez à la minute GPU tant qu'il tourne. Une connexion privée peut garder son port fermé à l'internet public.
Un même nom de modèle peut avoir plusieurs sources. Le router envoie chaque requête vers une source saine et rapide, garde une conversation sur la machine qui détient son cache et passe à une autre quand une machine ralentit.
En savoir plus
Kimi K3
DeepSeek V4.1 Flash 1017
DeepSeek V4.1 Flash
GLM 5.3 Flash
GLM 5.3
Aucun modèle ne correspond. Voir tous les modèles
Chat Completions, l'API Anthropic Messages et l'API Responses, plus les embeddings et la transcription, le tout avec la même clé.
Les préfixes de prompt répétés sont facturés automatiquement à un tarif réduit. Vous n'envoyez rien de plus.
Chaque modèle porte un score Bench issu de benchmarks publics, indiqué comme mesuré ou estimé, et les classements montrent la vitesse mesurée par modèle.
Servez un modèle de Hugging Face ou votre propre finetune sur un GPU dédié, démarré avec la recette vLLM officielle de ce modèle.
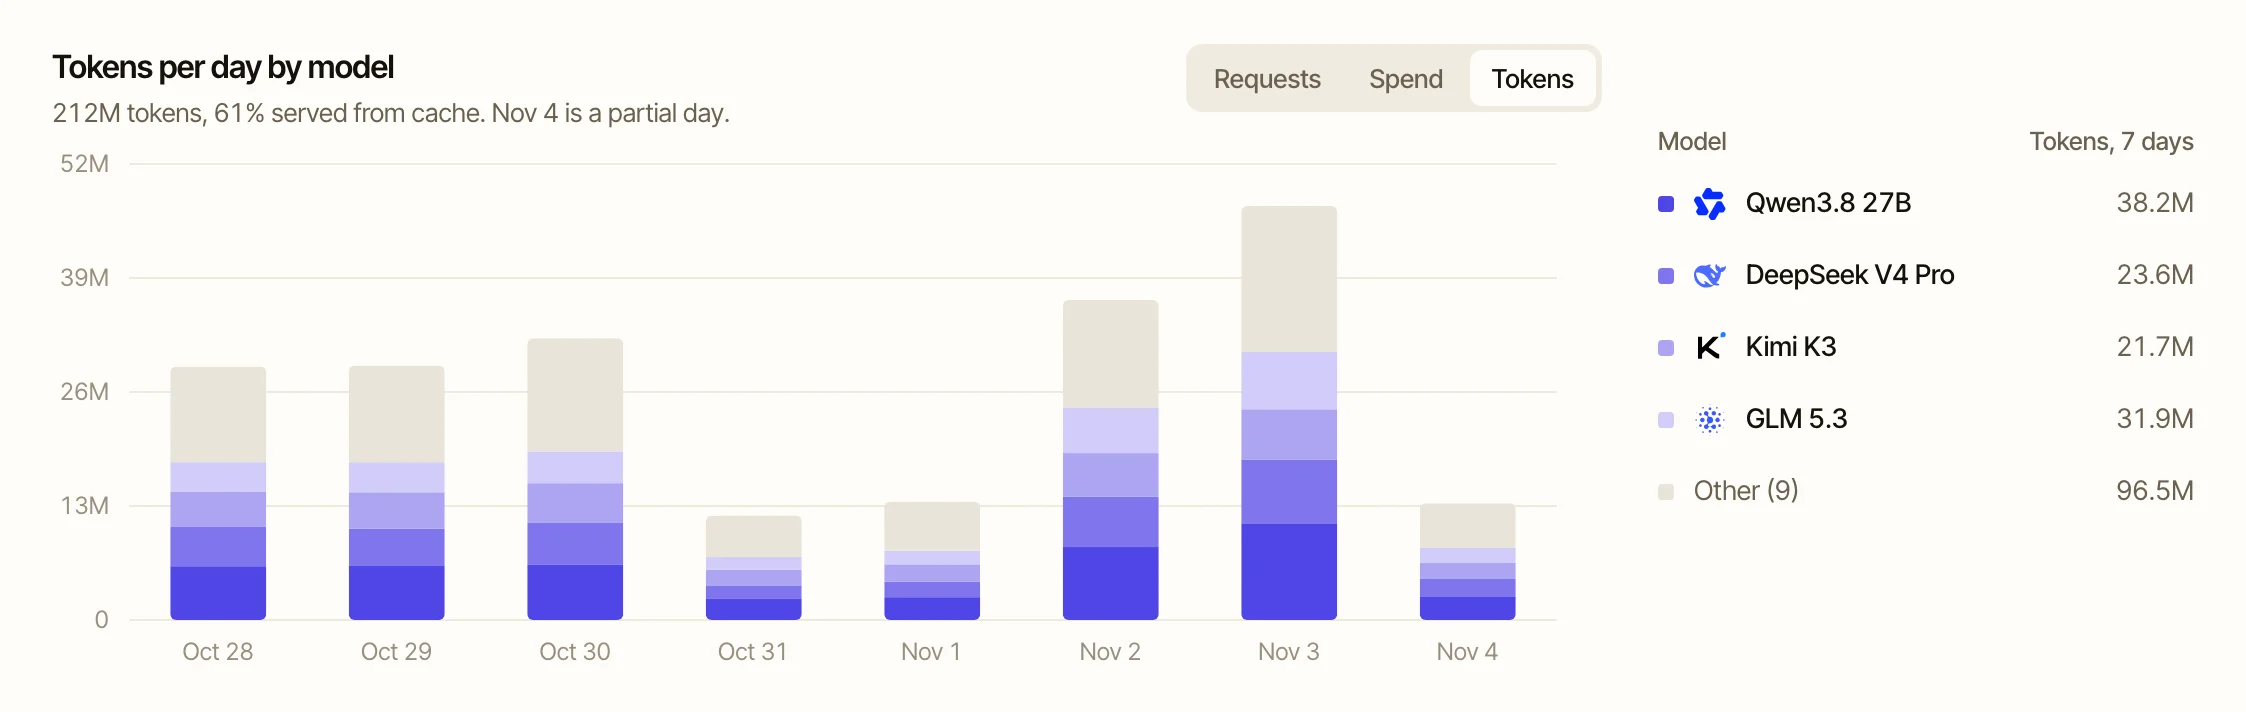
Tous les modèles du model garden indiqués comme disponibles. Nous ajoutons de nouveaux modèles ouverts après les avoir testés.
Quand le travail demande un modèle que personne d'autre ne fait tourner, une vitesse garantie ou une isolation complète. Pour la plupart des équipes, le partage au token reste moins cher jusqu'à des volumes très importants.
Oui. Définissez l'URL de base sur https://hostyourai.com/api/v1 et utilisez votre clé HostYourAI. Le SDK Anthropic fonctionne de la même façon.
Commencez par une couche et ajoutez les autres quand le travail le demande. Elles partagent une clé, un solde et une vue Activity.
Une seule clé vous donne accès à tous les modèles du garden. Rechargez des crédits et payez au token, sans abonnement.