Una API para todos los modelos
Chat Completions, la Anthropic Messages API y la Responses API, además de embeddings y transcripción, todo con la misma clave.
03 Serve $ hyai models
Compartidos por token, o solo para usted, desde centros de datos europeos.
 GLM
 DeepSeek
 Qwen
 Kimi
 Mistral
 Llama
 gpt-oss
 Gemma
 Loes
 Nemotron
 Claude Code
 Codex
 OpenCode
 Cursor
 Cline
Loes
OpenAI SDK
 Anthropic SDK
Qué hace
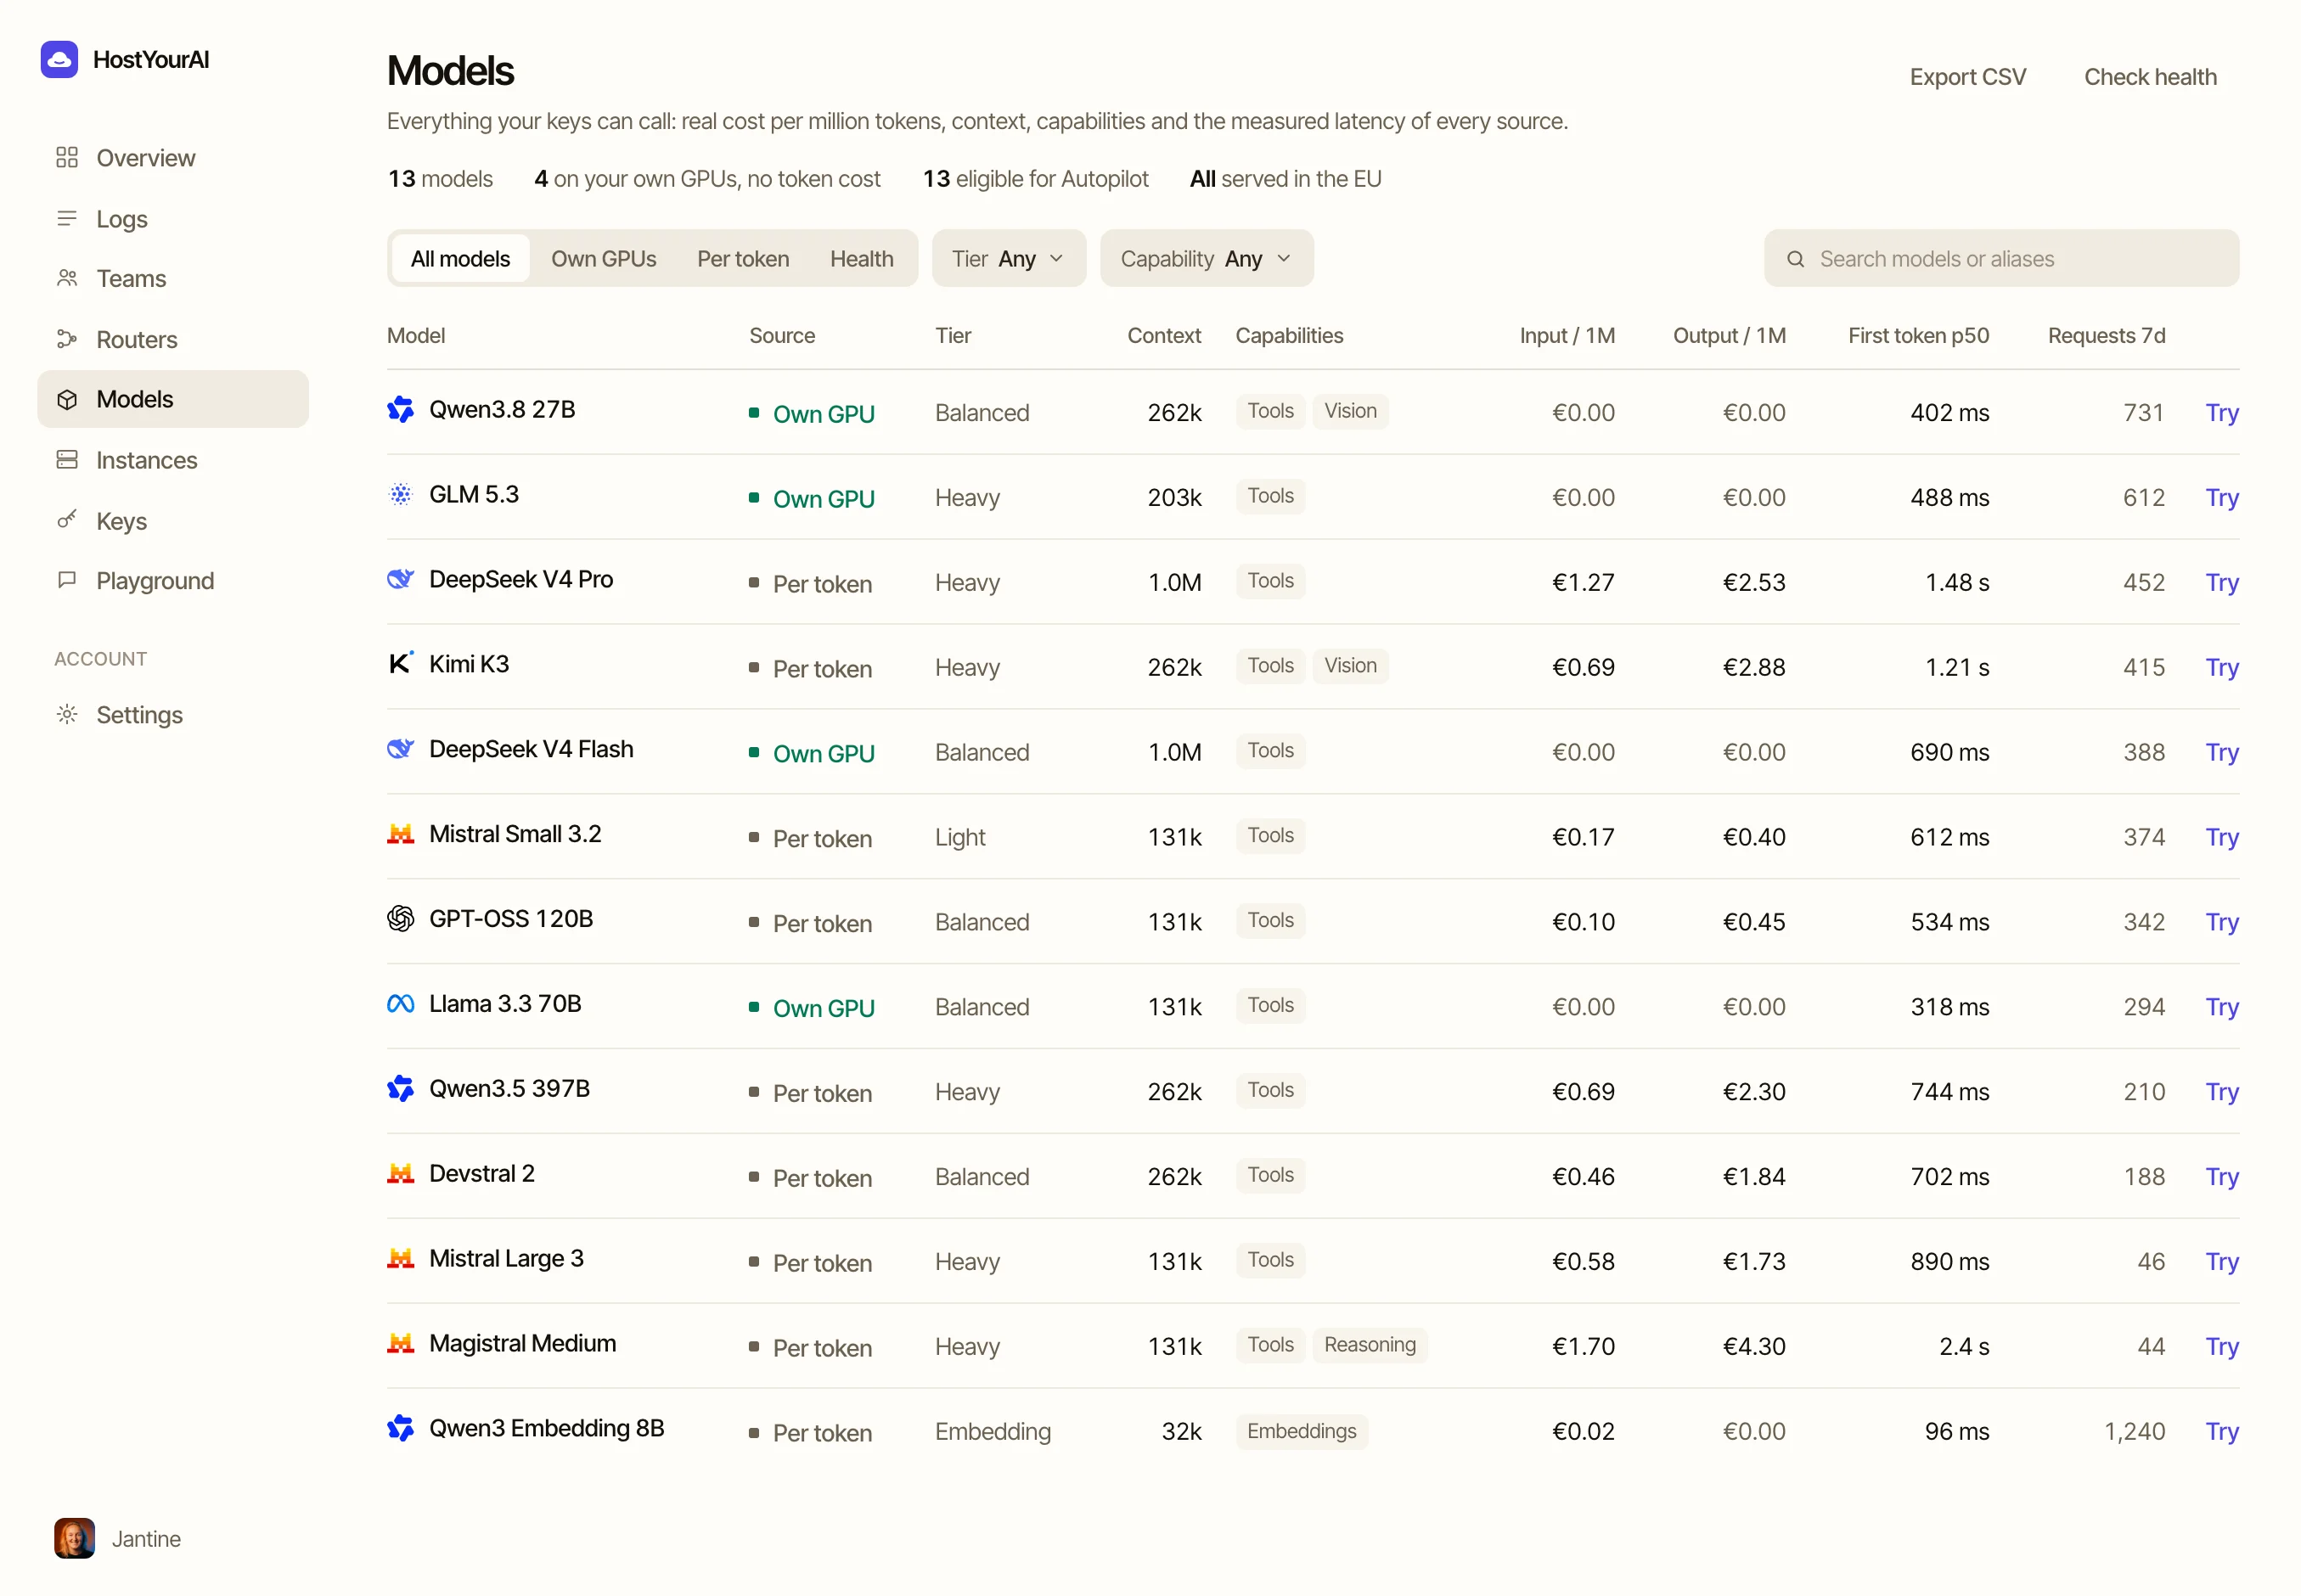
El catálogo de modelos muestra los modelos abiertos a los que puede llamar ahora mismo. Los modelos compartidos funcionan por token en GPU de Europa: paga por lo que usa y no hay ninguna máquina que gestionar. Cada modelo tiene su propia página con su longitud de contexto, su precio por millón de tokens y una puntuación de calidad.
Cuando un modelo tiene que trabajar solo para usted, ejecútelo en una GPU dedicada. Usted mismo la crea y la elimina, en el panel o a través de la API, y paga por minuto de GPU mientras funciona. Una conexión privada puede mantener su puerto cerrado a la internet pública.
Detrás de un mismo nombre de modelo puede haber varias fuentes. El router envía cada solicitud a una fuente que funciona bien y es rápida, mantiene una conversación en la máquina que guarda su caché y cambia de máquina cuando una se ralentiza.
Más información
DeepSeek V4.1 Flash
DeepSeek V4 Flash
GLM 5.3 Flash
Qwen3.8 27B
Ningún modelo coincide. Ver todos los modelos
Chat Completions, la Anthropic Messages API y la Responses API, además de embeddings y transcripción, todo con la misma clave.
Los prefijos de prompt repetidos se facturan automáticamente a una tarifa más baja. No tiene que enviar nada adicional.
Cada modelo lleva una puntuación Bench basada en benchmarks públicos, marcada como medida o estimada, y la clasificación muestra la velocidad medida por modelo.
Sirva un modelo de Hugging Face o su propio finetune en una GPU dedicada, arrancado con la receta oficial de vLLM para ese modelo.
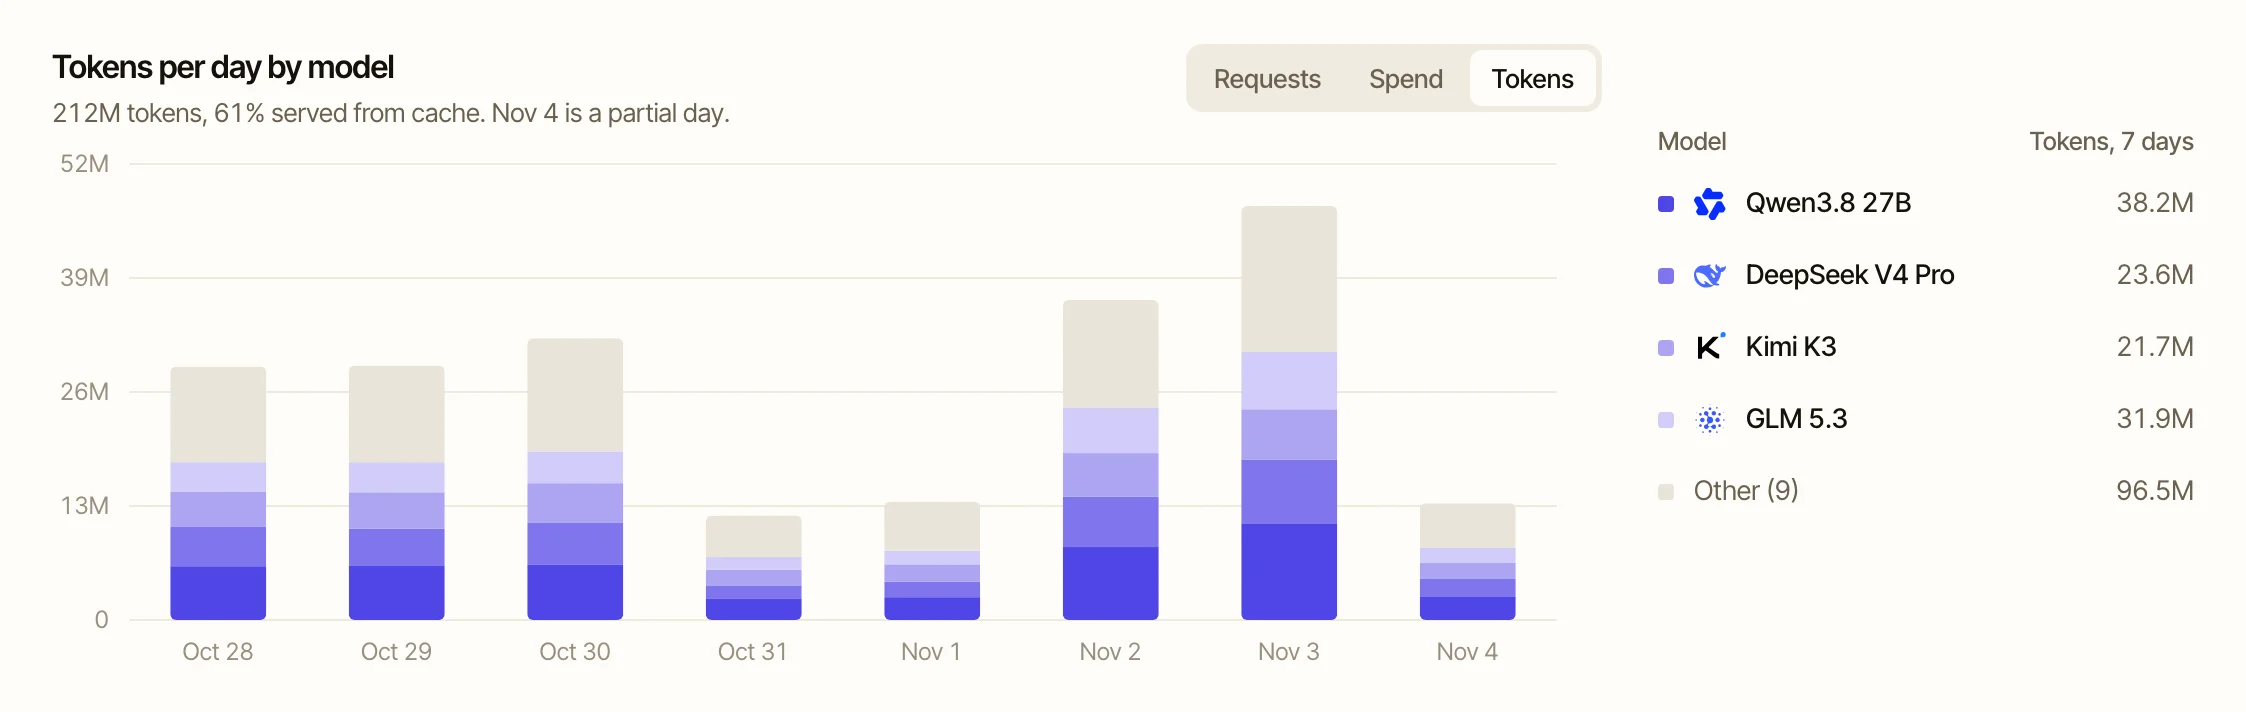
Todos los modelos del catálogo que aparecen como disponibles. Añadimos nuevos modelos abiertos después de probarlos.
Cuando el trabajo necesita un modelo que nadie más ejecuta, una velocidad garantizada o un aislamiento total. Para la mayoría de los equipos, lo compartido por token sigue siendo más barato hasta que el volumen es muy grande.
Sí. Configure la URL base como https://hostyourai.com/api/v1 y use su clave de HostYourAI. El SDK de Anthropic funciona del mismo modo.
Empiece con una capa y añada las demás cuando el trabajo lo pida. Comparten una clave, un saldo y una vista Activity.
Su agente de programación con modelos abiertos en Europa, configurado con un solo comando.
AbrirClaves, presupuestos y barreras por equipo, y datos personales detenidos antes de que un modelo los vea.
AbrirGPU privadas en Europa, de H100 a B300, dimensionadas según el tiempo de respuesta, la velocidad de generación y los usuarios simultáneos.
AbrirUna sola clave le da acceso a todos los modelos del catálogo. Recargue crédito y pague por token, sin suscripción.